Como uma rede neural aprende sem ninguém ensinar? Abri uma que joga sozinha
Cada neurônio é só uma conta, o botão apertado é a saída com o maior valor e, na evolução, ninguém corrige o cérebro: os clones que vão mais longe têm filhos com mutações aleatórias, como medi num jogo em outubro de 2026.

João Thaira
7 min de leitura · 26 de outubro de 2026Lido por 1 IA: Meta
Como uma rede neural aprende sem ninguém ensinar?
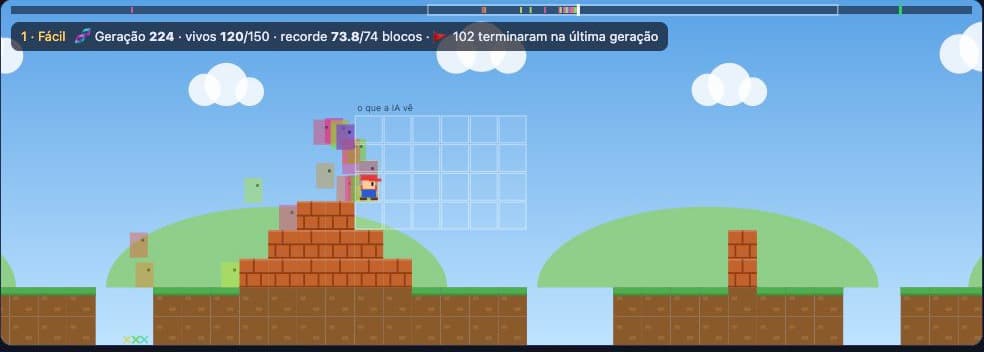
Eu escrevo aqui sobre treinar e ajustar modelos de linguagem. Mas eu queria entender, com número, o que acontece no nível mais baixo de todos: um neurônio. Então montei, com o Claude Code, um jogo de plataforma no estilo Mario em que uma rede neural pequena aprende sozinha a chegar à bandeira, e em que cada peso aparece na tela. Depois pausei o jogo em momentos específicos e li os números. O código está aberto e o jogo roda no navegador, então dá para repetir tudo: os links estão nas fontes, no fim.

O que a IA vê?
A IA não vê a tela. Ela recebe 26 números, recalculados 15 vezes por segundo. 24 vêm de uma grade de 6 blocos à frente por 4 linhas em volta dos pés, em que 1 é sólido, −1 é perigo (espinho ou inimigo) e 0 é vazio. Os outros 2 são a velocidade vertical e se ela está pisando no chão.

Na maior parte do tempo, mais de 20 desses números valem 0. Isso importa, porque 0 vezes qualquer peso dá 0: essas entradas simplesmente não contam. E há uma limitação que só percebi lendo os números: a linha do chão olha só o bloco logo abaixo dos pés, então um degrau e um buraco aparecem iguais.
O que um neurônio faz, de verdade?
Uma conta. Cada neurônio multiplica cada entrada pelo seu peso, soma tudo, soma um valor fixo chamado viés e passa o resultado pela tanh, uma função que espreme qualquer número para o intervalo de −1 a 1:
saída = tanh(viés + peso₁ × entrada₁ + … + peso₂₆ × entrada₂₆)
Todos os neurônios usam a mesma fórmula. O que diferencia um do outro são os pesos e o viés. Um exemplo com uma entrada só, "tem chão 2 blocos à frente" (1 ou 0), com peso −3 e viés +2: com chão, tanh(2 − 3) = −0,76; com buraco, tanh(2) = +0,96. Acabou de nascer um detector de buraco.
Os pesos começam sorteados perto de zero, e o viés começa em zero. A rede do jogo tem 26 entradas, 12 neurônios ocultos e 4 saídas, 376 números ao todo. Aprender é só achar bons valores para eles.
Como a rede escolhe o botão?
As 4 saídas (esperar, correr, pular e voltar) também são neurônios: fazem a mesma conta sobre os 12 neurônios ocultos, só que sem a tanh. O maior valor ganha e vira o botão apertado.
Um neurônio oculto não dispara uma ação. Ele vota em todos os botões ao mesmo tempo, com um peso para cada um. Ativação negativa vezes peso positivo é voto contra, então ficar "desligado" também é um voto. A decisão sai da soma dos 12 votos mais o viés de cada botão.
O que aconteceu dentro dela num pulo de verdade?
Pausei o campeão da geração 218 descendo em cima de um bloco de tijolo. Ele decidiu correr. O neurônio mais ativo, o 9, tem peso −2,66 na entrada "chão embaixo de mim": a soma deu −3,12 e a saída, −1,00. Ele funciona como um sinal de "tenho chão firme", e o voto dele em pular foi −0,96, contra.


Duas decisões depois, na beirada, ele pulou. Três entradas tinham mudado: o chão à frente sumiu, a velocidade foi a zero e ele passou a pisar no chão. O neurônio 6, que tem peso +1,49 em "chão à frente" e −2,20 em "pisando no chão", foi de +0,98 para −0,91. O 8 fez quase o mesmo. Como os dois têm pesos grandes ligados a correr, a nota de correr caiu de 7,58 para 1,31, e pular venceu com 4,76.
O curioso: o viés de pular nesse cérebro é +4,57, o maior dos quatro. Ele quer pular por padrão, e são os neurônios que seguram essa vontade quando a situação é segura. E esse pulo nem era necessário: era um degrau, não um buraco. Os olhos dele não sabem a diferença.
Cada neurônio vira especialista em alguma coisa?
Um pouco, e por acaso. Desliguei os 12 neurônios do campeão, um de cada vez, e com qualquer um desligado ele morre: metade das vezes no primeiro buraco, no bloco 11. O conhecimento fica espalhado pelo time.
Depois treinei 4 cérebros do zero e, em cada um, mostrei a mesma parede de 2 tijolos para ver qual neurônio mais empurrava o pulo:
| Treino | Quem fez o trabalho |
|---|---|
| 1 | neurônios 11 (51%) e 4 (46%) |
| 2 | neurônio 10 (69%) |
| 3 | neurônios 4 (47%) e 12 (39%) |
| 4 | neurônios 2 (40%) e 8 (34%) |
Cada vez é um neurônio diferente, às vezes dois dividindo o papel. Todos estão ligados a todos os botões desde o nascimento; o que muda é a força de cada ligação, e fica com o papel quem teve sorte primeiro.
Se ninguém corrige o erro, como ela melhora?
O clone que cai no buraco nunca fica sabendo. Durante a vida os pesos ficam congelados, e no fim da geração cada clone recebe só uma nota: os blocos que percorreu, mais um bônus se chegou à bandeira. A nota não diz onde errou nem qual peso culpar.
A nota decide quem vira pai. Os 5 melhores passam iguais para a geração seguinte. Os outros 145 filhos têm pais escolhidos por torneio (o melhor de 3 sorteados), metade mistura os pesos de dois pais, e cerca de 10% dos pesos de cada filho levam um empurrão aleatório. A mutação é cega; o aprendizado está no filtro.
Parece ingênuo, mas funciona em escala. Em 2017, pesquisadores da Uber AI Labs fizeram isso com redes profundas:
"we evolve the weights of a DNN with a simple, gradient-free, population-based genetic algorithm (GA) and it performs well on hard deep RL problems, including Atari and humanoid locomotion."
— Such et al., Deep Neuroevolution (2017)
Em português: eles evoluíram os pesos de uma rede profunda com um algoritmo genético simples, sem gradiente e baseado em população, e ele foi bem em problemas difíceis de aprendizado por reforço, como jogos de Atari e a locomoção de um humanoide. As redes deles passavam de 4 milhões de parâmetros; a minha tem 376.
O jogo também tem o outro caminho, o DQN, em que o agente recebe −5 no instante em que morre e a retropropagação calcula quanto cada peso teve de culpa. Foi esse método que, em 2013, superou um jogador humano especialista em 3 de 7 jogos de Atari (Mnih et al.).
Quantos neurônios uma rede dessas precisa?
Menos do que eu imaginava. Em outubro de 2026, treinei 4 vezes cada tamanho de camada oculta e anotei em que geração um clone chegou à bandeira pela primeira vez:
| Neurônios ocultos | Pesos e vieses | Fase fácil | Fase com espinhos e inimigos |
|---|---|---|---|
| 1 | 35 | 1, 1, 1, 2 | 16, 17, 27, 48 |
| 4 | 128 | 2, 6, 8, 8 | 20, 32, 80, e um não chegou em 120 |
| 12 | 376 | 6, 7, 7, 7 | 27, 40, 54, 58 |
| 48 | 1.492 | 4, 6, 6, 6 | 35, 46, 64, 107 |
Com 1 neurônio a rede aprendeu mais rápido. Essas fases pedem uma regra simples, e mais neurônios só dão mais pesos para a evolução acertar no escuro. Não medi fases novas, em que mais neurônios provavelmente ajudam a generalizar.
Um neurônio só, porém, tem um limite clássico: ele separa as situações com uma linha reta, então não resolve o XOR, que é ligar quando só uma de duas entradas vale 1. Esse limite está no centro do livro Perceptrons, de Minsky e Papert, de 1969. Com 2 neurônios ocultos e 1 de saída, o XOR sai. É para isso que existem as camadas.
redes neuraisneuroevoluçãoaprendizado por reforçoDQNalgoritmo genético